Uberduck AI 是一款集文字转语音、AI 配音与音乐创作于一体的工具类应用,当前版本为 1.0.0。它内置了超过 5000 种音色,覆盖名人模仿、卡通角色、虚拟歌手等多种类型。使用时只需输入文本,挑选一个目标声音,就能在数秒内生成自然流畅的语音文件。无论是做短视频配音、辅助教育内容,还是用于营销推广,它都能派上用场,支持的语言和声音类型也比较丰富。
账号登录步骤
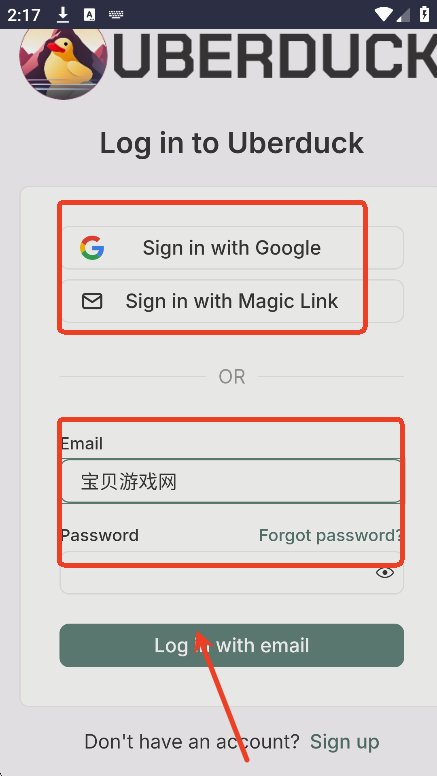
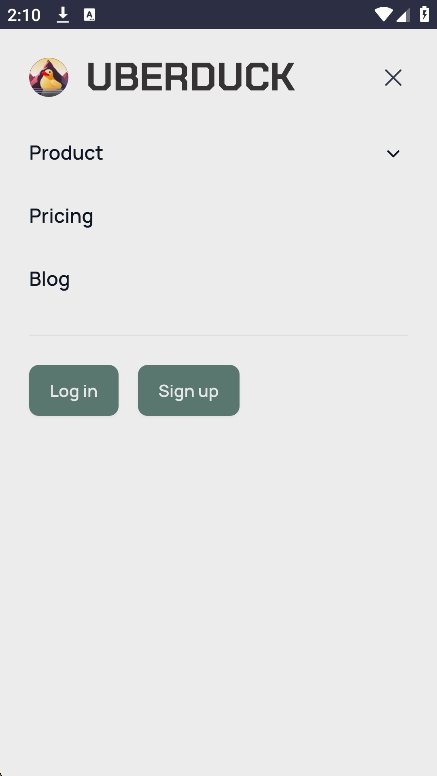
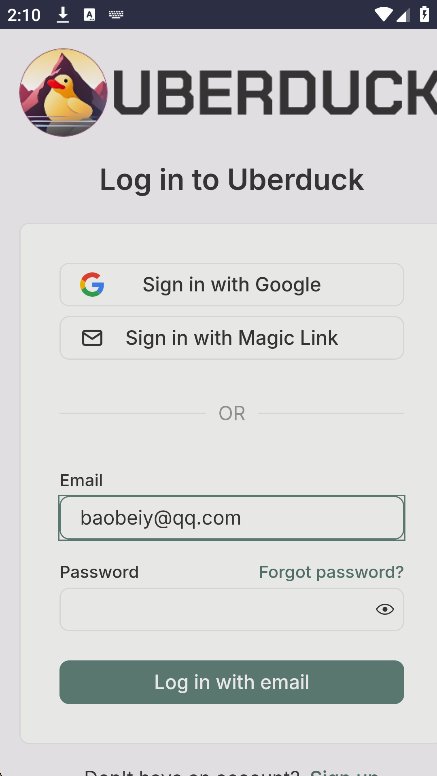
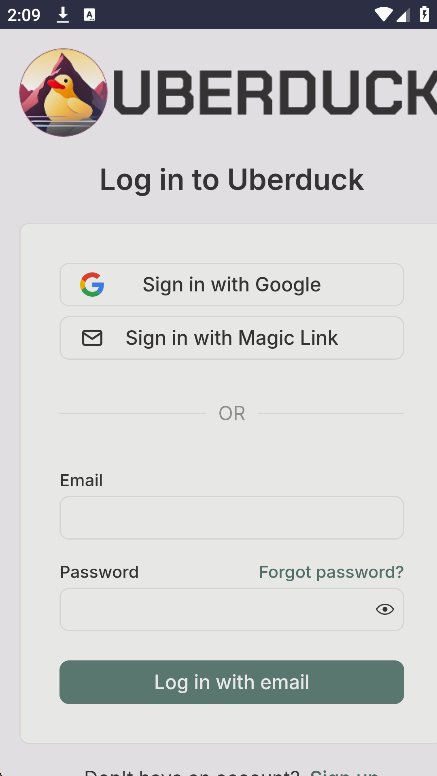
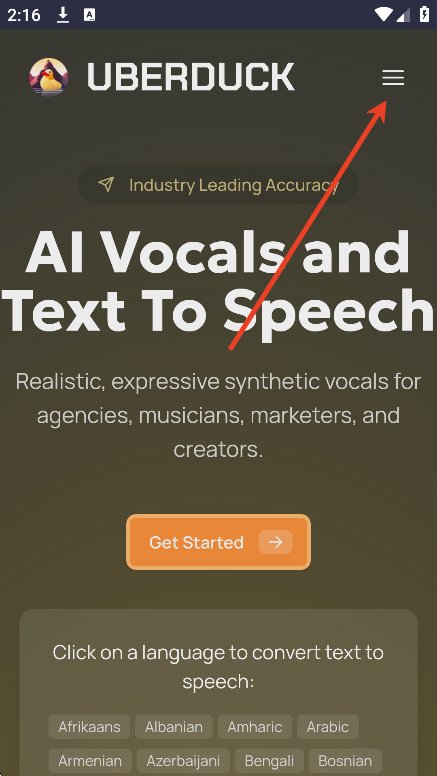
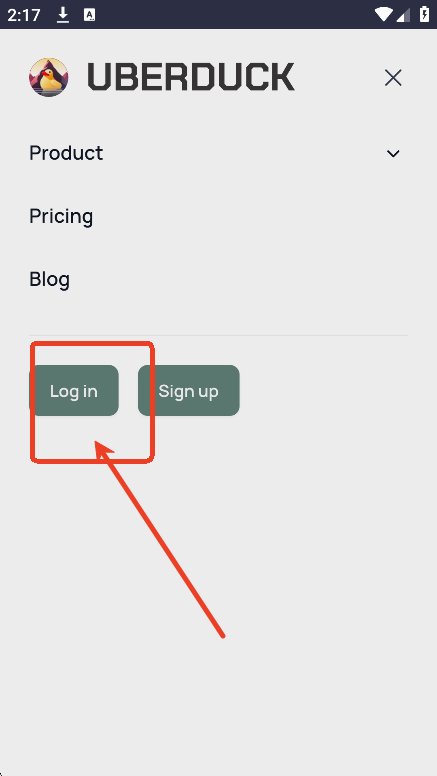
打开应用后,先进入首页,点击右上角的「三杠」菜单图标,在展开的选项里选择「Login」。登录方式比较灵活,支持邮箱账号或谷歌账号直接授权。选定一种方式后,输入对应账号信息并确认,即可完成登录,整个过程没有额外门槛。
快速上手:文本转语音与说唱生成
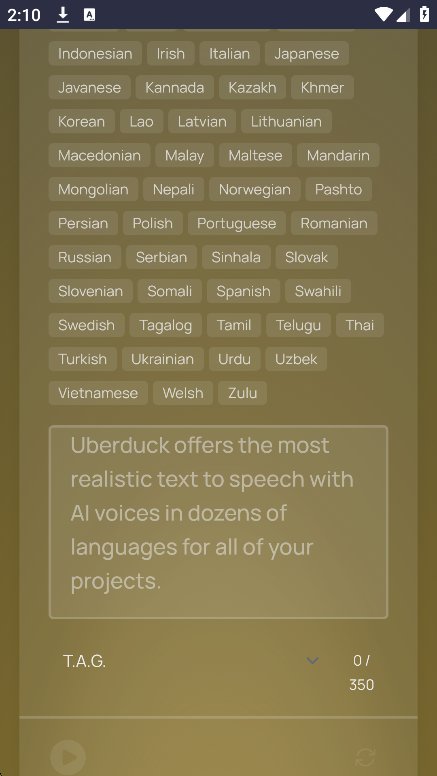
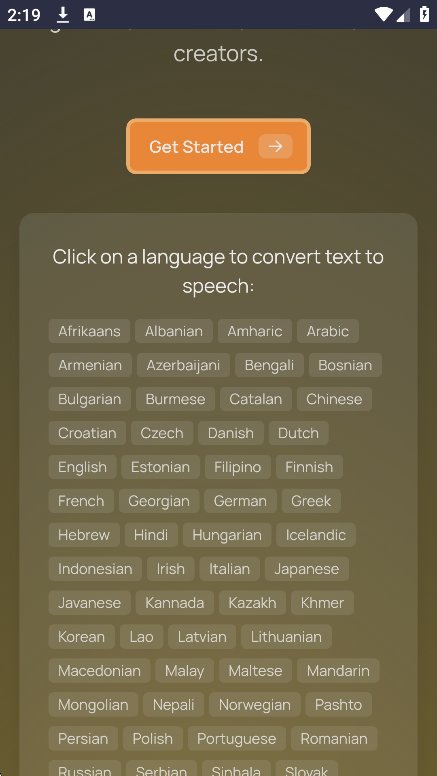
要把一段文字变成语音,操作路径很直接。在首页的文本框里输入想要转换的内容,比如「你好,欢迎使用Uberduck」。接着点击「Voice」下拉菜单,从 5000+ 的声音库中挑选合适的音色,也可以通过搜索栏直接输入关键词(例如「SpongeBob」)来快速定位某个特定声音。选好后点击「Synthesize」按钮,等待 1 到 3 秒,合成便完成。最后点「Download」就能把生成结果保存为 .wav 格式的音频文件。
如果觉得基础的文本转语音不够用,它还提供了一些进阶玩法。比如切换到「Rap」模式,输入几句歌词(像「I'm the king of the world」),AI 会自动为其配上节奏和韵律,生成一段说唱。同时,想要更个性化的声音,可以上传自己或他人的 20 分钟以上语音样本,训练一个专属的声音克隆模型,之后就能用这个克隆音色来做合成。对于开发者而言,它还开放了 API 接口,按照文档说明就能把语音合成能力嵌入到自己开发的程序里。
核心功能一览
音乐创作与说唱生成方面,Uberduck 能够根据用户输入自动生成说唱歌词,并支持定制歌词视频。同时,它也能基于歌词进行原创音乐创作,最终输出带有 AI 人声的完整歌曲,适合用来做音乐灵感草稿或趣味内容。
声音克隆与定制是另一大亮点。用户只需准备一段超过 20 分钟的录音素材,应用便会基于此训练 AI 模型,实现对特定声音的克隆或模仿。这项能力可以用于视频、游戏或动画项目的定制化配音,省去不少录音棚的成本。
对于有编程背景的用户,API 接口的开放让集成变得容易。开发者可以将文本到语音、文本到歌唱、文本到说唱等核心能力接入自己的音频应用或工作流中,实现更多个性化的场景。