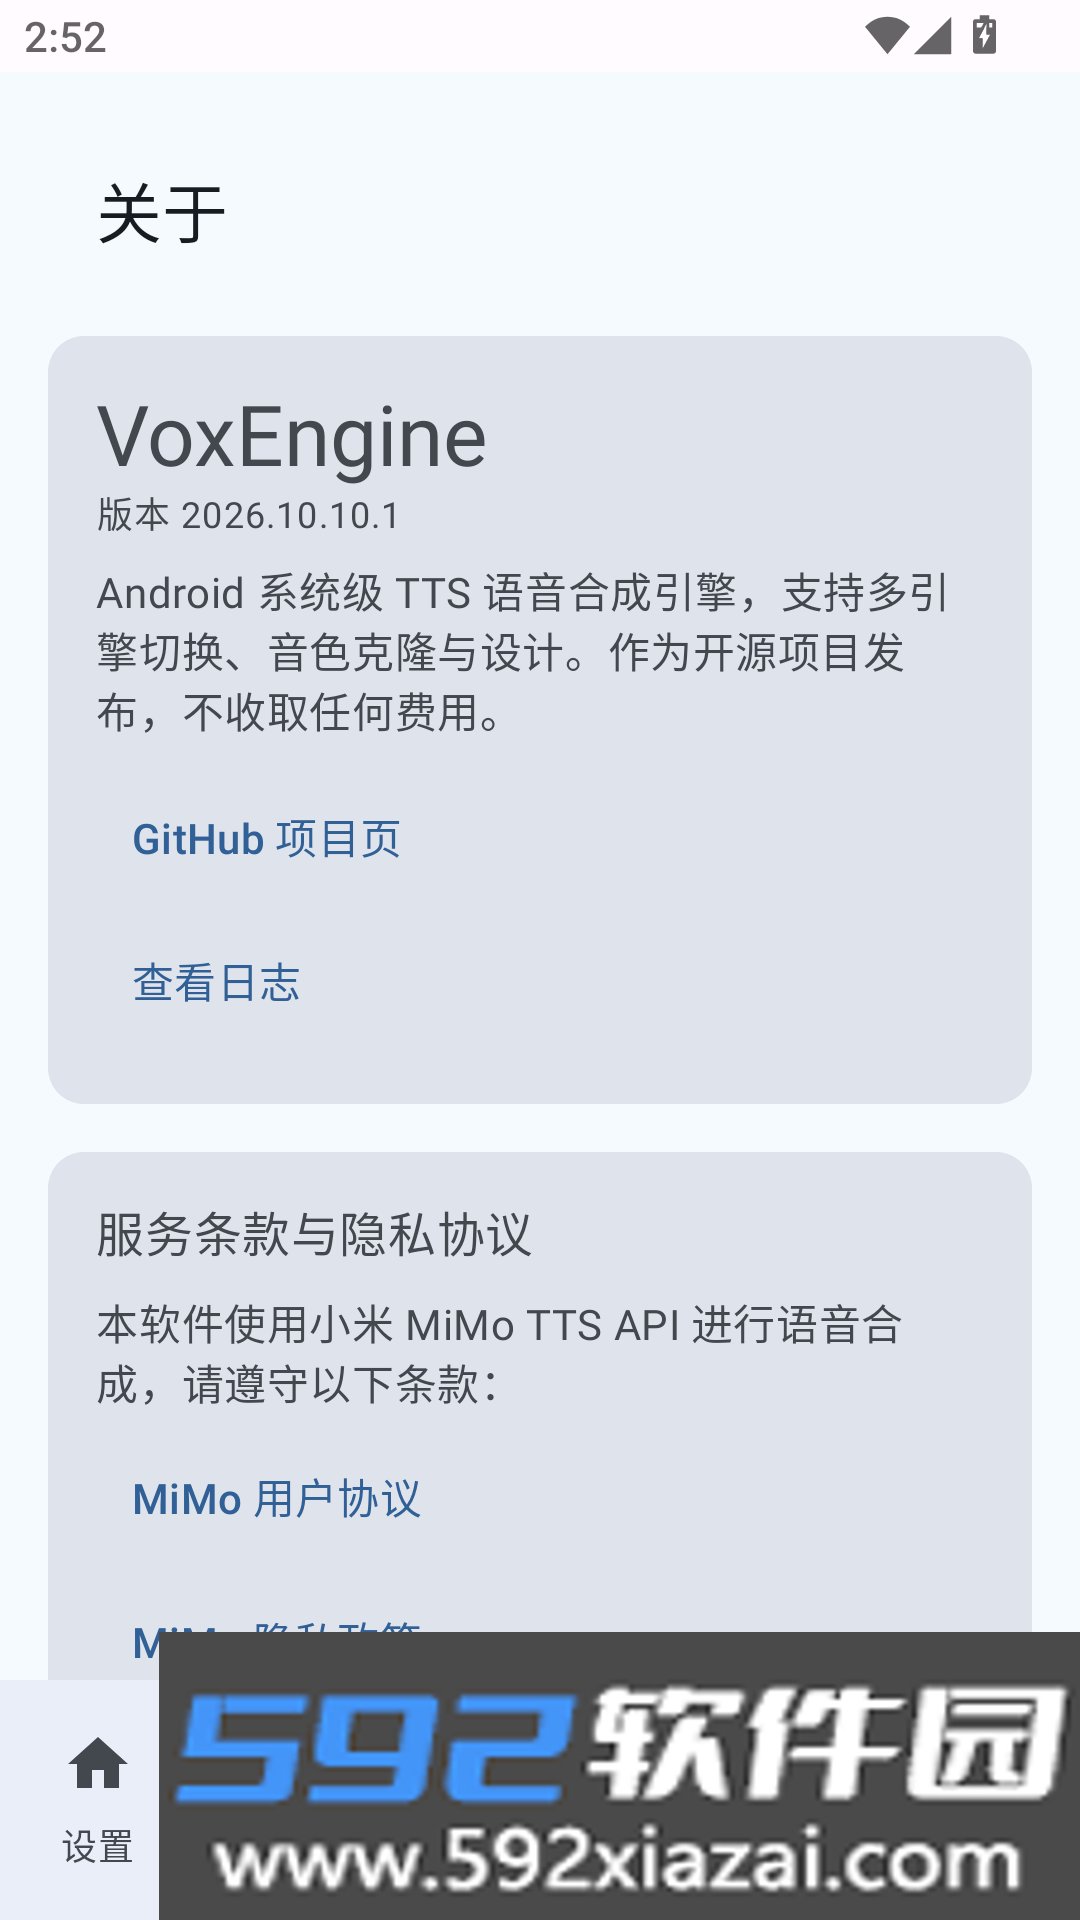
VoxEngine 是一款跑在 Android 系统层的 TTS 语音合成引擎,支持 MiMo 与微软 Edge 多引擎热切换。内置多套中英文预设音色,能自动识别语言,也提供音色克隆、文字生成音色、情绪风格控制等定制能力。应用里还整合了阅读书架和听书模块,阅读、无障碍辅助、个性化语音创作都能用。
产品定位
注册成系统服务之后,VoxEngine 会作为 Android 原生 TextToSpeechService 运行,Legado 这类支持系统 TTS 的应用可以直接调用,不用单独适配。
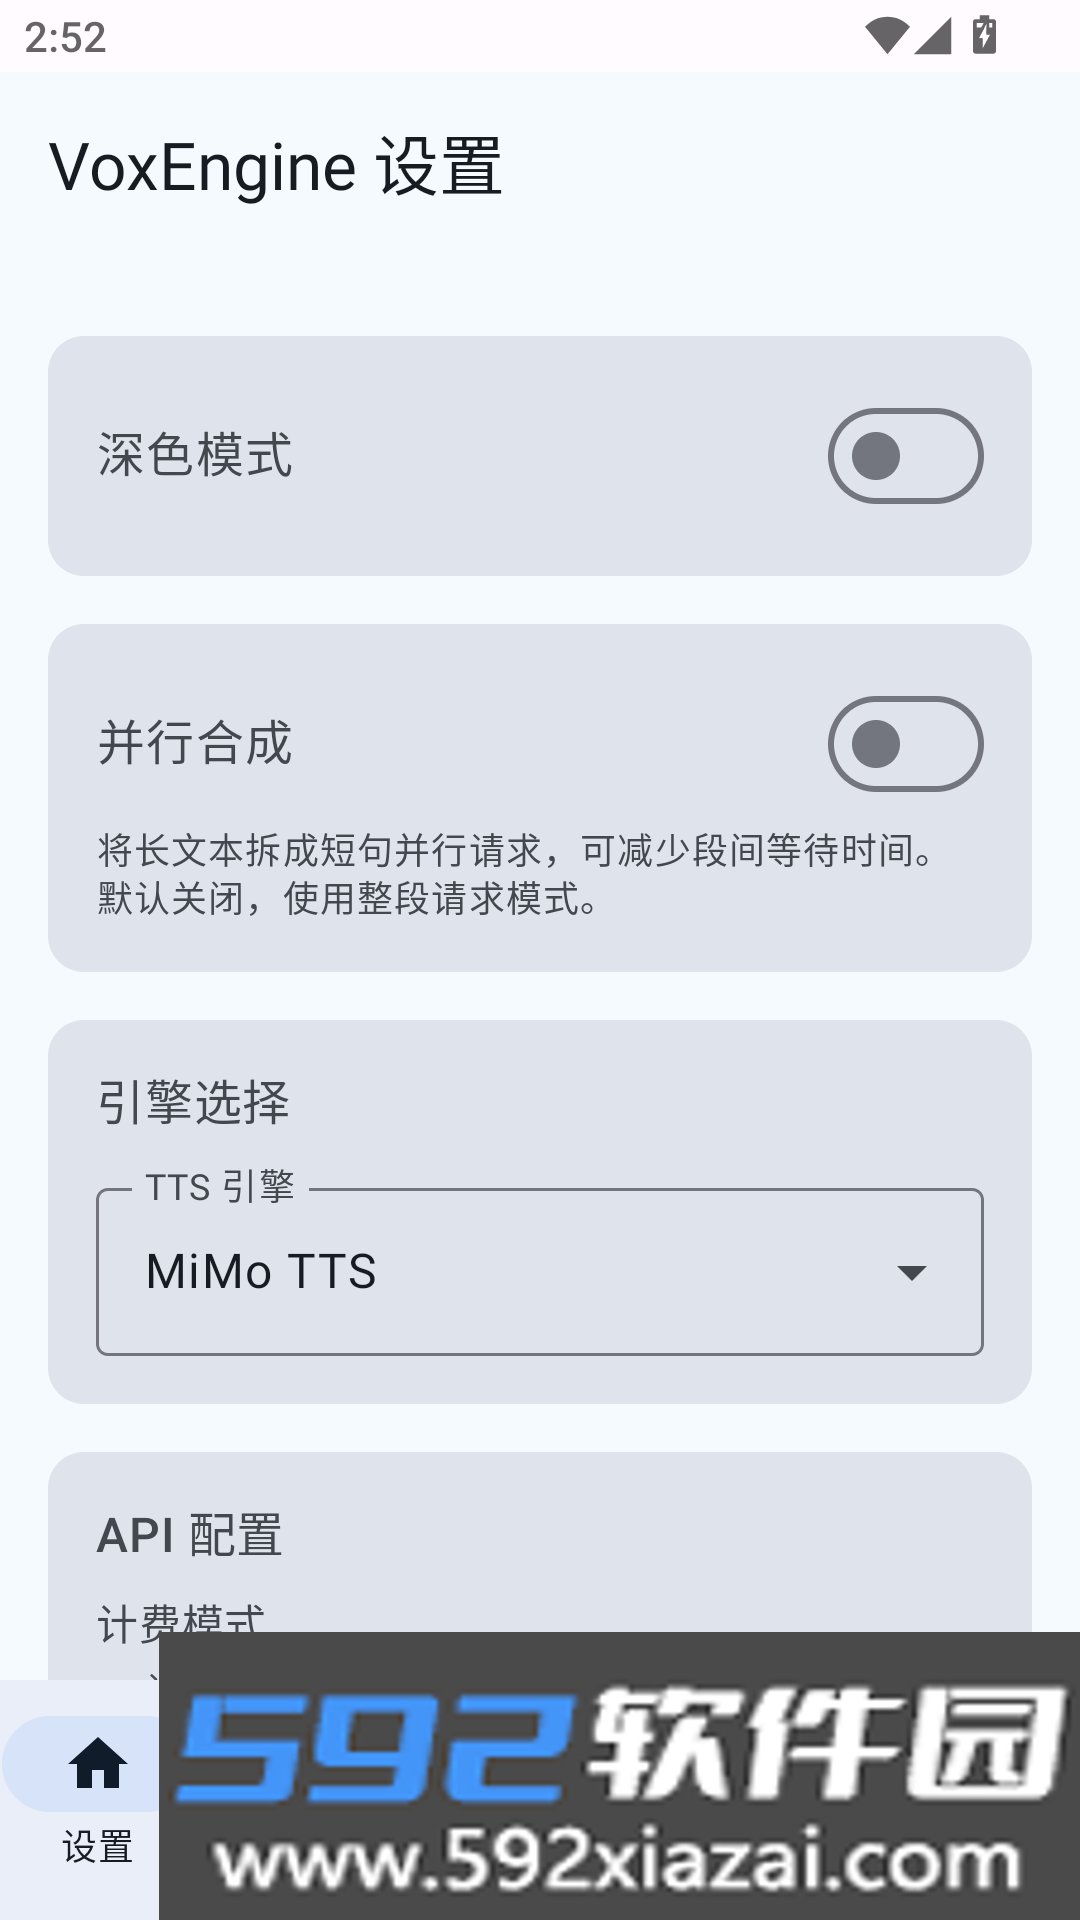
引擎部分采用可插拔架构和统一接口,目前接入了 MiMo TTS 与微软 Edge TTS,后续还能继续扩展其他语音合成后端。
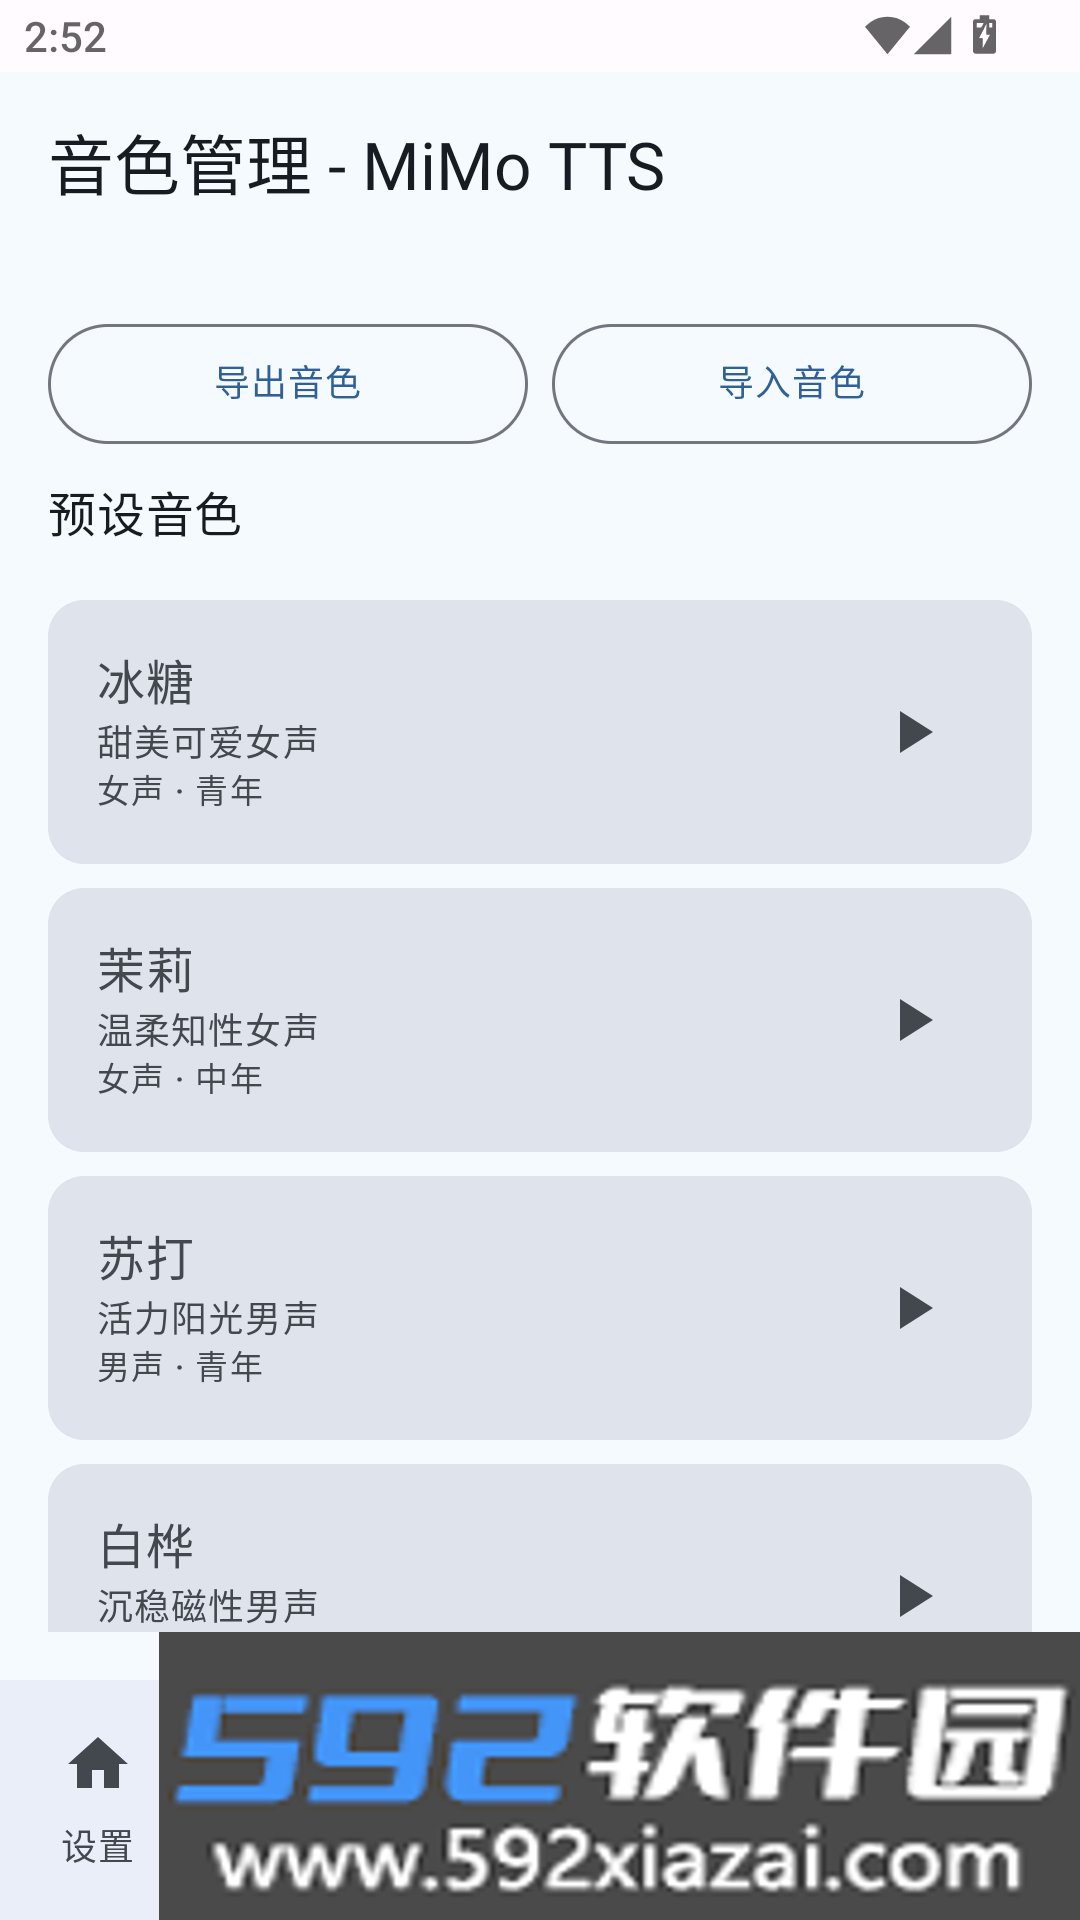
音色方面内置了冰糖、茉莉、Mia 等多套中英文预设,开箱即用;想要更个性化的声音,可以用音频样本克隆,或者直接用文字描述生成新音色。
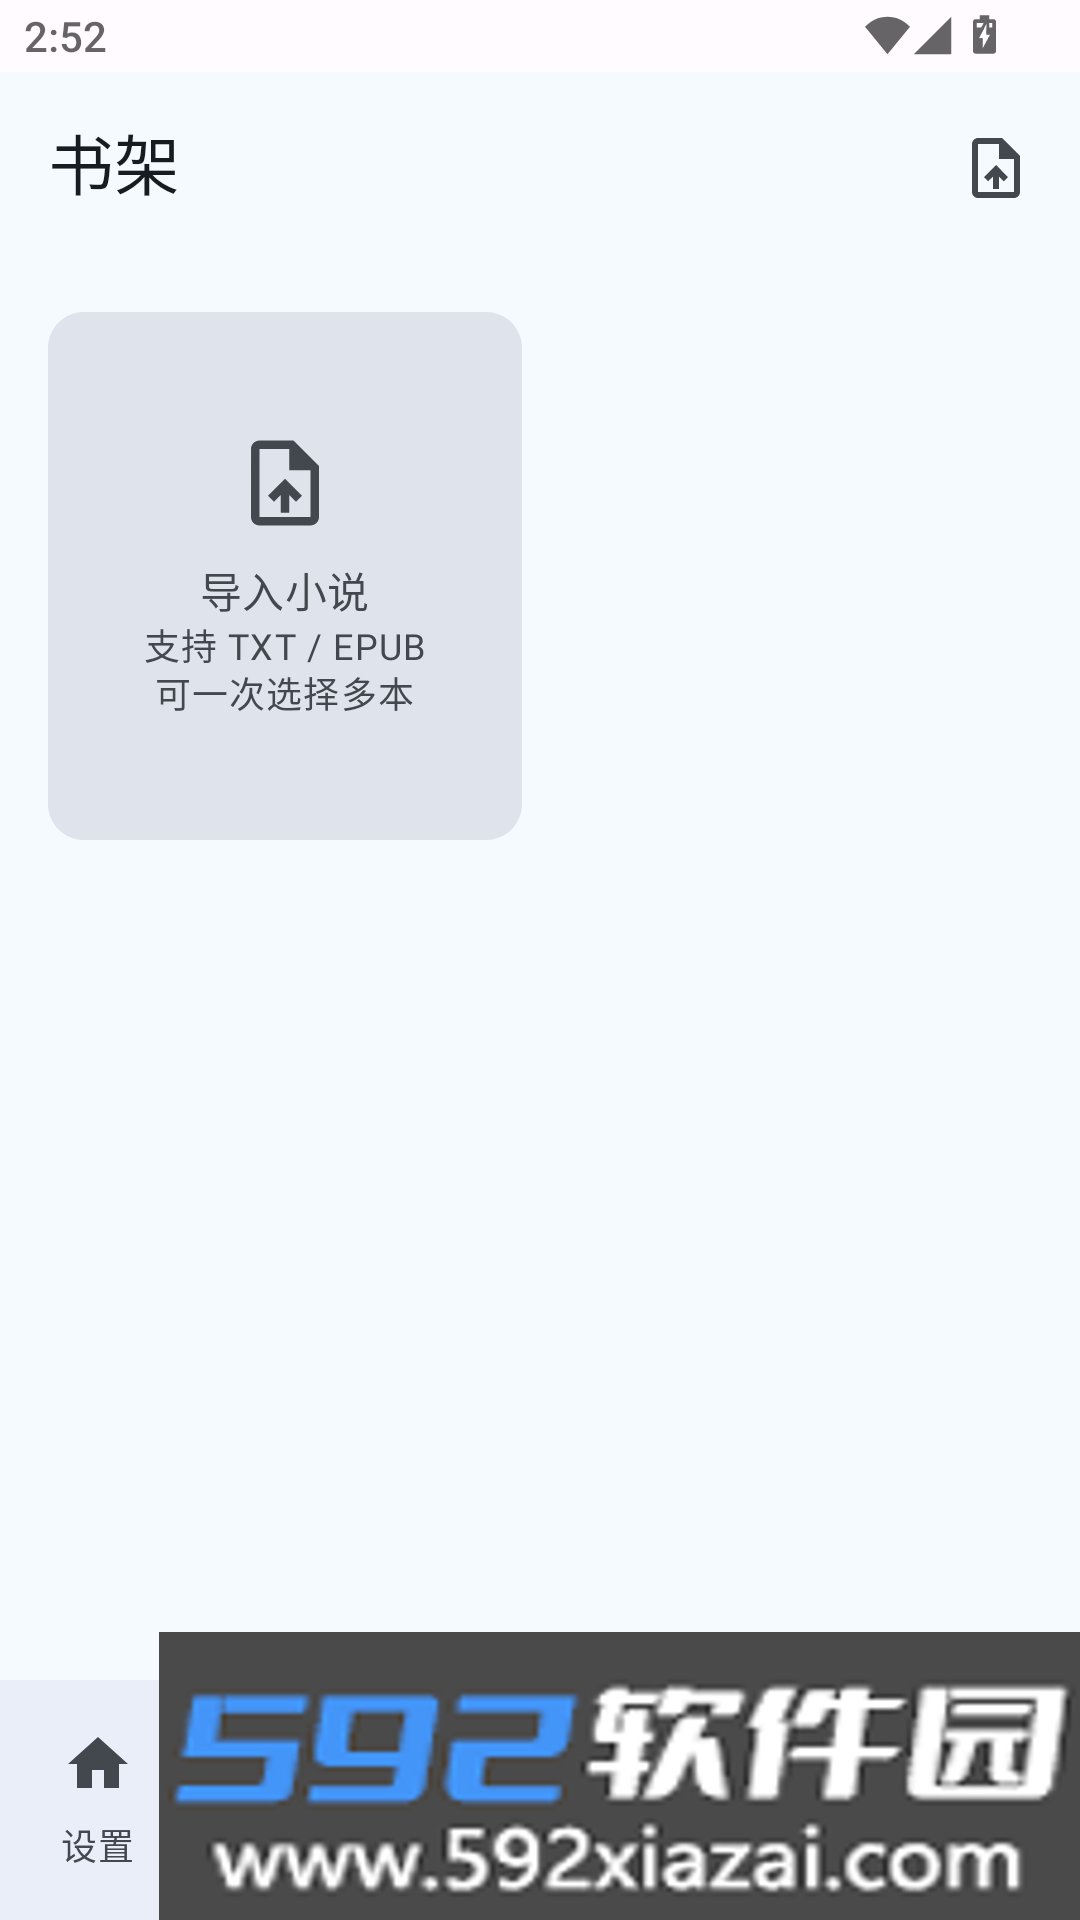
阅读听书模块支持导入本地 TXT 和 EPUB 小说,按章节朗读并保存进度,阅读和听书可以连在一起用。
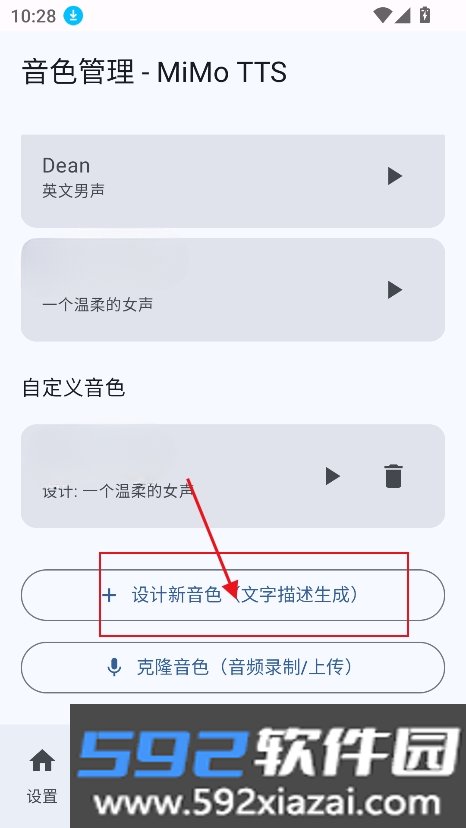
新音色添加方法
1. 进入音色管理界面,选择【设计新音色】或【克隆音色】。
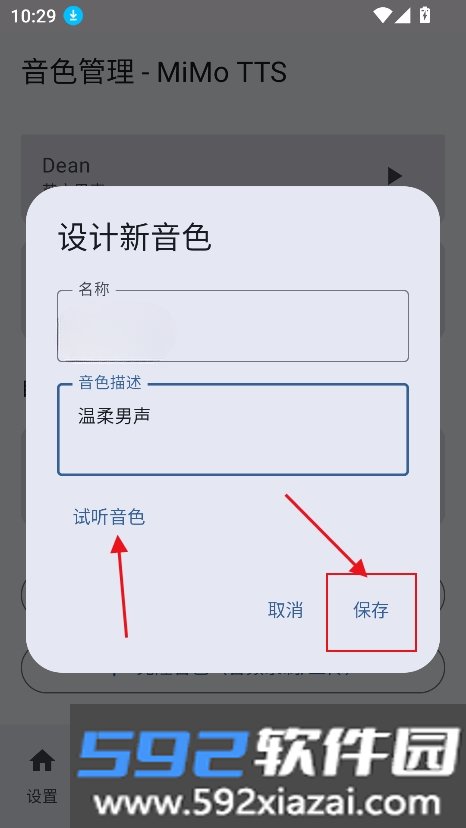
2. 输入音色名称、音色描述等内容,可以先试听,也可以直接点【保存】。
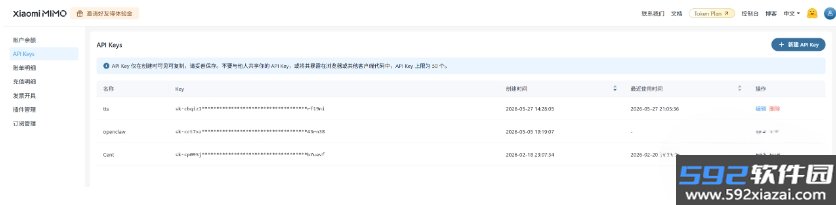
API Key 获取流程
1. 前往小米 MiMo TTS 平台注册账号,在控制台新建 API Key。
2. 新手建议选按量计费模式,目前限时免费,生成的 API Key 以 sk- 开头。
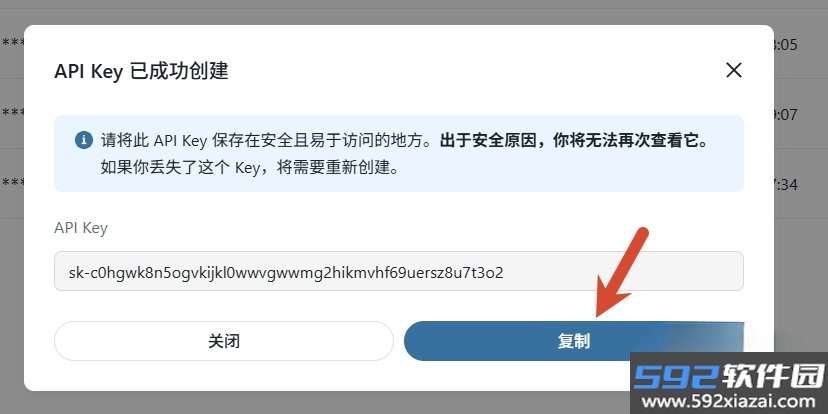
3. 创建完成后把 API Key 复制下来即可。
功能特性一览
· 系统级集成:以 Android 原生 TextToSpeechService 方式运行,支持系统 TTS 的应用都能直接调用,无需额外适配。
· 多引擎架构:可插拔设计配合统一接口,当前兼容 MiMo TTS 与微软 Edge TTS,后续可接入更多后端。
· 预设音色库:内置多种中英文音色,覆盖日常阅读和多语种场景。
· 语言自动识别:根据当前选中的音色自动上报对应语言代码,英文、日文、中文可以智能切换,不用手动设置。
· 音色克隆:上传或录制一段短音频,就能复刻目标人声,保留原音色特征和情感表达细节。
· 文字生音色:只靠文字描述就能生成全新的定制音色,不需要准备任何音频素材。
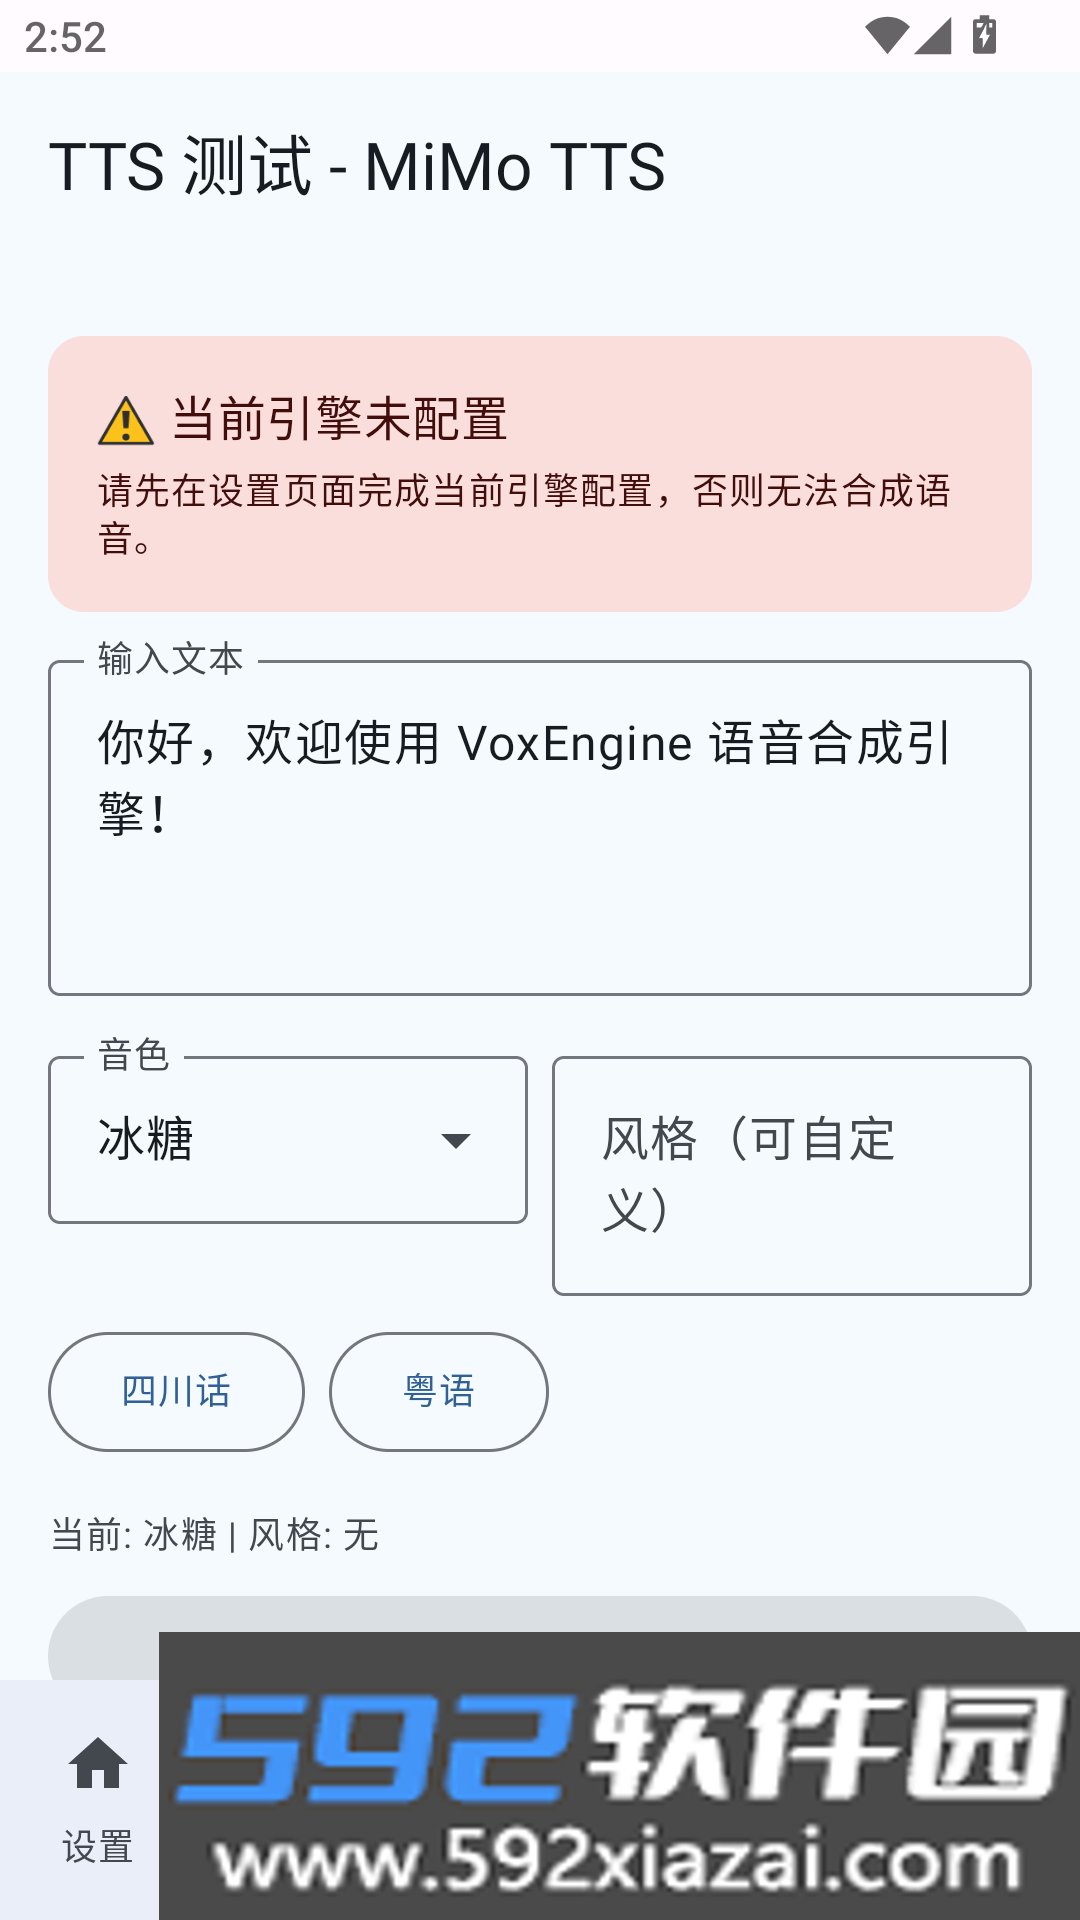
· 风格精细控制:支持情绪、语调、方言、角色扮演等标签化调节,用一句话指令就能实时切换发音表现力。
· 内置阅读听书:整合本地 TXT/EPUB 阅读器与听书功能,可以从任意位置开始朗读,并自动保存阅读进度。
核心优势
1. 音色语言自动识别机制:系统 TTS 语言会跟随当前默认音色智能切换,多语种内容不用手动调整。
2. 风格控制标签化:情绪、语调、方言、角色扮演等都能用标签切换,一句话就能改变发音风格,增强表现力。
3. 听书稳定性优化:预取失败时会自动补合成当前段落,避免网络抖动造成跳段,保证连续收听。
4. 克隆音色限流设置:可以自定义请求间隔、重试次数和等待时间,兼顾效率与服务合规性。
产品亮点
1. 把专业级语音合成能力下沉到系统层,打破应用之间的隔离,让 TTS 直接融入日常阅读和信息获取流程。
2. 音色设计不再依赖原始音频,仅凭文字描述就能生成个性化声音,降低定制门槛和创作成本。
3. 日志查询导出和音色 JSON 备份分享机制完善,既方便排查问题,也有利于社区协作和音色资源流通复用。
版本说明
· 修复 MiMo 合成请求中前后段落原文与「上下文」标签可能被读出的问题,避免重复朗读或前后听起来错乱。现在请求不再携带上下文原文,只传递当前应朗读的正文。
· 覆盖内置听书、系统 TTS 和并行分段合成入口;预设、克隆、设计音色及设计预览均不再发送上下文原文。
· 预设/克隆音色在未指定风格时,会从上下文提取简短的本地情绪提示;已指定风格的保持不变。设计音色保留原有音色描述与预览行为。
· 更新音频缓存版本,避免继续复用旧的异常音频。升级后旧缓存不再命中,需要重新合成或重新执行预缓存。